Continue aprendendo enquanto ouve.
O que você precisa saber
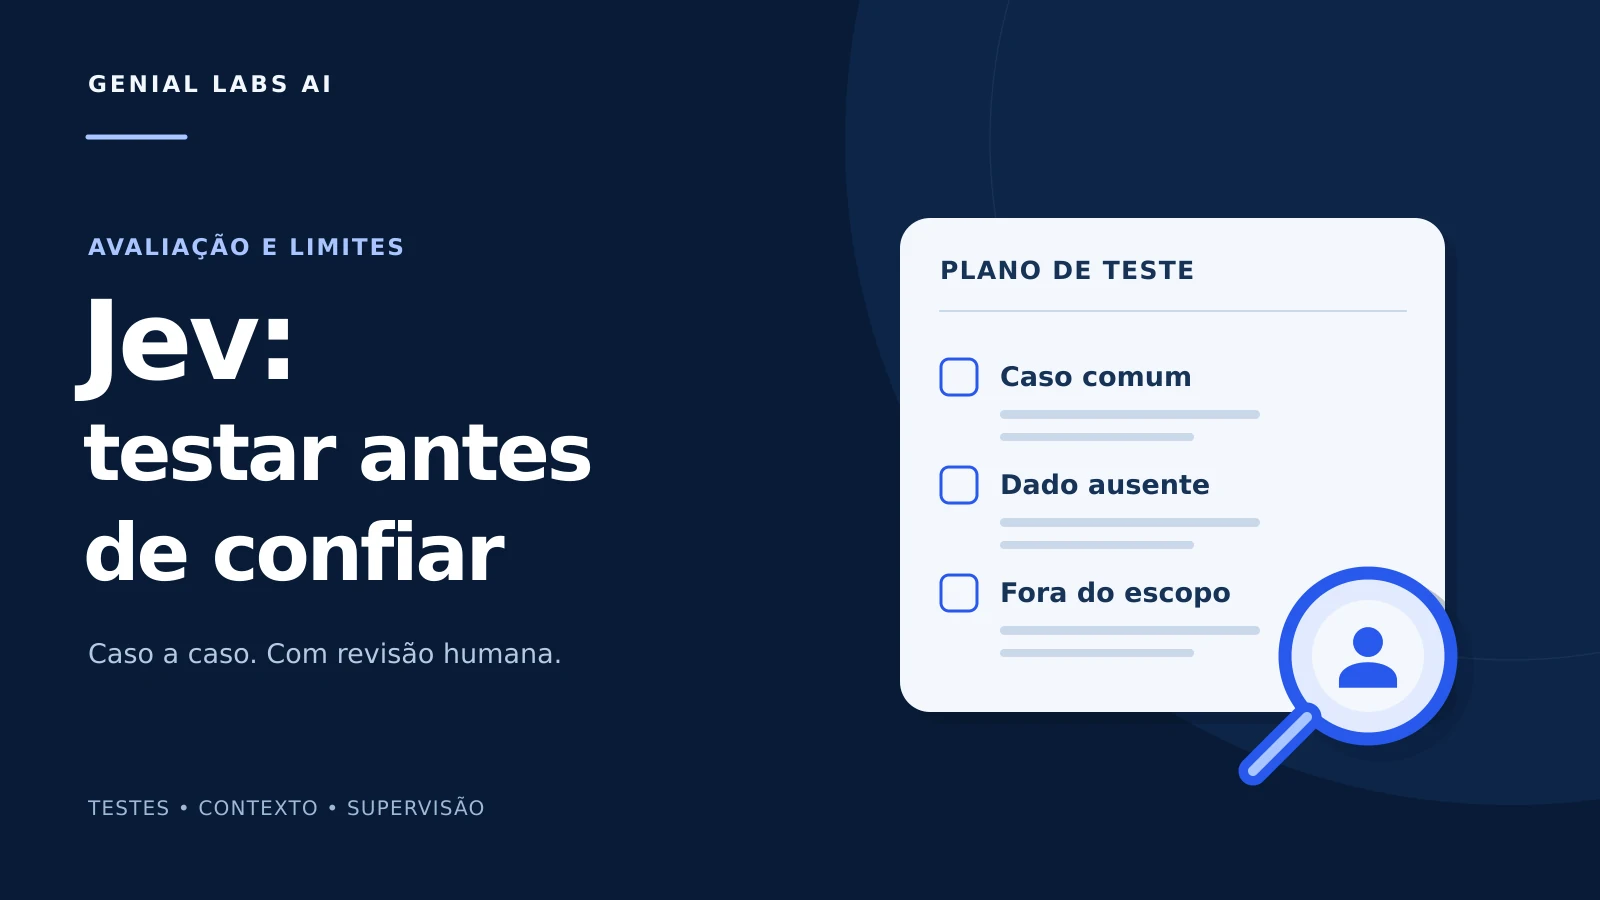
Teste o agente na tarefa completa, com resultados esperados e casos de falha. Avalie resposta, ação e estado final separadamente. A autonomia deve crescer depois de evidência repetida, com limite de permissão, responsável por exceções e forma clara de interromper o fluxo.
- Uma resposta convincente não prova que a ação foi executada e persistida.
- O conjunto de teste precisa incluir situações sem resposta e ações fora da permissão.
- Mudanças de modelo, fonte ou ferramenta pedem nova avaliação dos casos afetados.
Leve esta leitura para a prática: conheça o caderno gratuito e suas fichas editáveis.
Camadas de proteção para um agente
Cada camada controla um risco diferente. Selecione uma etapa para ver seu papel.
Entrada não confiável
Mensagens, páginas e documentos podem conter instruções maliciosas. Conteúdo recuperado deve ser tratado como dado.
Na prática: Uma página não pode autorizar o agente a revelar um segredo.
Instruções e contexto
Separe instruções do sistema, pedidos do usuário e conteúdo de fontes. Limite dados expostos ao mínimo necessário.
Na prática: Não coloque credenciais no prompt ou em arquivos que o modelo possa consultar.
Executor e permissões
O sistema valida ferramentas, parâmetros e acesso por usuário/organização fora da LLM.
Na prática: Uma saída do modelo não concede permissão para acessar outro cliente.
Revisão e limites
Ações de maior impacto exigem confirmação e limites de escopo, volume e duração.
Na prática: Enviar uma mensagem e preparar um rascunho devem ter permissões distintas.
Teste e auditoria
Registre decisões sem vazar dados sensíveis e teste falhas, abuso e recuperação.
Na prática: Uma tentativa bloqueada é evidência de um controle; não prova ausência de todos os ataques.
Nenhuma instrução de prompt oferece blindagem total. A segurança depende de controles externos ao modelo e testes contínuos.
Transforme a promessa em um contrato de tarefa
Antes de testar, descreva o trabalho em termos observáveis. Preparar um resumo, consultar uma disponibilidade e registrar um interesse são tarefas diferentes. Para cada uma, registre entrada, informação necessária, permissões, saída e estado final esperado. Sem isso, a equipe avalia a impressão da conversa em vez da entrega.
A OpenAI recomenda avaliações específicas à tarefa, critérios claros e avaliação contínua. Essa orientação não oferece uma aprovação automática para qualquer agente. Ela ajuda a montar uma pergunta de trabalho: que evidência mostraria que este fluxo funciona nas situações que a empresa enfrenta?
Um caso hipotético de agendamento
Se o agente só propõe um horário, a saída esperada é uma sugestão correta. Se pode agendar, o teste precisa conferir disponibilidade, autorização, criação do compromisso e confirmação. O texto 'agendado' não substitui a leitura do registro no sistema que controla o calendário.
Monte uma coleção que represente a operação
Use casos autorizados e remova informações que não são necessárias. Distribua a amostra entre situações frequentes e exceções que têm impacto. Uma coleção formada apenas por perguntas fáceis favorece uma aprovação que desaparece quando o cliente escreve do próprio jeito.
Cada caso precisa de uma resposta ou comportamento esperado, com justificativa e fonte. Em tarefas de julgamento, a empresa deve dizer quem avalia e como trata discordância. Notas automáticas ajudam a triar, mas uma pontuação alta não encerra uma divergência sobre o que o agente tinha permissão para fazer.
Categorias que merecem entrar
O objetivo não é testar toda frase possível, e sim cobrir as condições que mudam a decisão.
- Caso normal com dados completos e fonte vigente.
- Pedido incompleto que exige esclarecimento.
- Informações contraditórias ou regra substituída.
- Pergunta fora do assunto ou sem resposta disponível.
- Tentativa de acessar dado de outra empresa ou unidade.
- Ação sem autorização, ferramenta indisponível e repetição da mesma solicitação.
Aprofunde este tema: Como criar um agente de IA que gera resultado na empresa →
Separe qualidade da resposta de qualidade da ação
Um agente pode escrever a resposta correta e executar a ação errada. Também pode executar uma ação válida e comunicar mal o resultado. Avalie as duas partes, incluindo o estado que ficou no sistema. Em uma operação com clientes, um erro de execução costuma ter consequências diferentes de uma frase pouco clara.
A proposta abaixo é uma matriz de decisão para adaptar à tarefa. Não é uma certificação, um padrão universal de nota nem um relato de resultado de cliente. A empresa deve calibrar aceitação e bloqueio conforme o impacto de cada falha.
| Dimensão | O que conferir | Evidência necessária |
|---|---|---|
| Contexto | Fonte vigente e pessoa/unidade corretas | Documento e filtro usados |
| Resposta | Precisão, limite e clareza | Comparação com resultado esperado |
| Ação | Permissão e parâmetros corretos | Registro da autorização e execução |
| Persistência | Estado final e ausência de duplicação | Leitura do sistema de destino |
| Exceção | Parada ou transferência útil | Destino e contexto entregue à pessoa |
Defina o que bloqueia a liberação
Não esconda uma falha grave dentro de uma média. Um conjunto pode acertar quase todos os casos e ainda permitir leitura indevida ou execução duplicada. Estabeleça quais situações impedem a liberação, independentemente da taxa de acerto geral. Para problemas menores, registre correção e prazo sem chamá-los de resolvidos.
A arquitetura também influencia a avaliação. A Anthropic distingue fluxos com etapas definidas de agentes com mais liberdade para decidir o caminho. Quanto maior a liberdade, mais importante observar decisões intermediárias, limites de ferramentas e condições de parada. Complexidade adicional precisa demonstrar utilidade para a tarefa.
Autonomia em etapas
Comece pela forma de trabalho que permite aprender com menor impacto. Um fluxo pode preparar uma sugestão para a equipe, depois consultar informações e só então executar ações limitadas. Essa sequência é uma proposta de implementação gradual, não uma garantia de segurança por si só.
- Avalie sem execução externa, com saída revisada pela equipe.
- Libere consultas dentro de uma permissão específica e registre o contexto.
- Teste ações reversíveis em ambiente de validação e confira o estado final.
- Defina quem pode ampliar o escopo e que falhas interrompem o fluxo.
- Acompanhe casos reais autorizados e mantenha um caminho humano para exceções.
A avaliação continua depois da publicação
Quando muda o modelo, uma regra ou uma integração, muda o sistema que foi avaliado. Reexecute os casos afetados e conserve a versão usada na comparação. Se você também alterou o conjunto de perguntas, registre a diferença: comparar números de coleções distintas pode produzir uma conclusão falsa.
Na operação, acompanhe falhas por tarefa e tipo. Observe correções humanas, ações duplicadas, transferências e informação ausente. Métricas de velocidade precisam vir junto com qualidade e custo. Responder mais rápido pode apenas deslocar trabalho para outra pessoa.
A Genial Labs AI trata avaliação como parte da entrega: hipótese, caso, resultado esperado, execução e evidência. A pergunta final não é se o agente parece inteligente. É se a empresa consegue explicar o que ele fez, por que estava autorizado e como corrigir quando a situação sair do previsto.
Prepare o próximo passo do seu projeto.
Use estas leituras para esclarecer dúvidas, preparar o escopo e conversar com sua equipe.
Qualidade, segurança, custo, logs e riscos.
Políticas, papéis, riscos e ciclo de vida.
Defina fontes, acesso e responsabilidades pelas conexões entre sistemas.
Contratação por tarefa, integrações, supervisão e critérios de aceite.
Quer um material complementar para aplicar este artigo?Opcional, sem interromper a leitura
Agentes de IA no negócio: decidir, testar e operar
Decida quando um agente faz sentido e organize missão, fontes, permissões e supervisão. Registre evidências antes de ampliar sua atuação.